Perché le integrazioni custom per il Digital Trust si rompono al primo timeout di rete
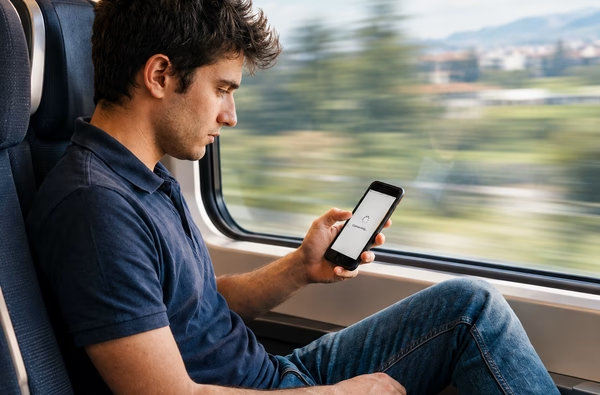
Qualche giorno fa ho provato a cambiare il contratto del gas dal telefono mentre viaggiavo in treno. Avevo del tempo libero e ho pensato di approfittarne.
Mi sono trovato di fronte un’interfaccia pulita, pochi campi da compilare, caricamento del documento via fotocamera scattato in un secondo, tutto fluido e perfetto. Poi siamo arrivati al passaggio decisivo: la verifica con SPID. Clicco, vengo reindirizzato all’app del provider, confermo l’identità come al solito e attendo il rientro sulla pagina della compagnia energetica.
Proprio in quel momento il treno entra in galleria, la rete 4G sparisce per qualche secondo.
Quando la connessione torna, sullo schermo del telefono compare una schermata bianca con un testo conciso: Sessione scaduta. Si prega di ricominciare da capo.
Cosa pensa un utente comune in quel momento? Chiude la scheda, mette via il telefono e si dice che ci riproverà appena avrà di nuovo tempo (spoiler: non lo farà più).
Cosa pensa invece un CTO o un Responsabile Infrastruttura quando guarda i dati di quel drop-off? Pensa al codice che è stato scritto dal proprio team IT per collegare le API di identità al gestionale interno. E si chiede se anche quel codice nasconda qualche difetto strutturale.
Il problema, di solito, sta tutto in quella colla di codice usata nel mezzo.
Il limite dell’architettura tradizionale nelle integrazioni SPID e Firma digitale
Quando un’azienda decide di digitalizzare un onboarding o la firma di un contratto, la scelta più naturale sembra sempre la stessa: comprare i connettori dai fornitori di certificati (SPID, CIE, Firma Elettronica) e farli integrare dal proprio team di sviluppo con i sistemi già in uso.
Le API dei provider funzionano. Seguono le specifiche di AgID per le regole tecniche e i parametri di timeout sessione. Rispettano i requisiti definiti dallo Standard eIDAS 2.0 sul quadro europeo dell’identità digitale, ma la logica operativa tradizionale le unisce quasi sempre scrivendole in modo lineare.
Richiesta Dati -> Chiamata SPID -> Verifica Documento -> Generazione PDF -> Firma OTP
In un mondo ideale con connessioni in fibra ottica e utenti infallibili, questo schema funziona, anzi funzionerebbe. Il problema è che il mondo reale è fatto di passaggi in galleria, codici OTP ricevuti in ritardo e documenti sfocati caricati dal divano.
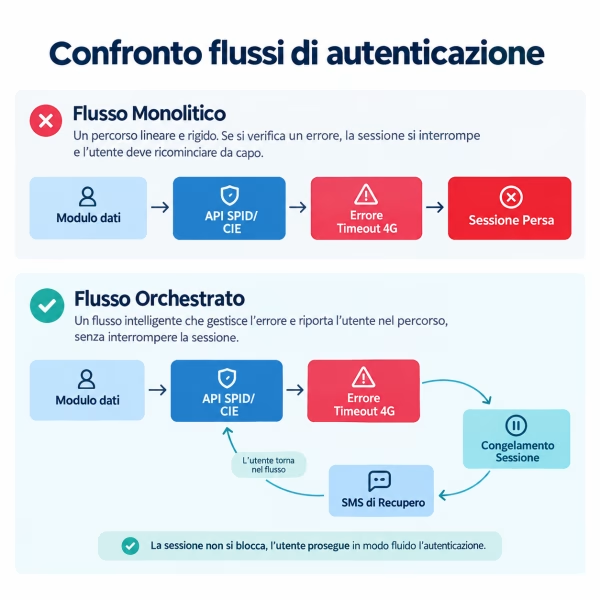
Se uno solo di questi passaggi fallisce o va in timeout, il flusso si interrompe. Il codice applicativo va in eccezione, la sessione scade e il sistema cancella i dati già raccolti. È il classico approccio monolitico: tutto deve funzionare in una singola sequenza sincrona, altrimenti non funziona nulla.
Come l’architettura a macchina a stati gestisce gli errori di rete
Per evitare questo tipo di blocco non serve riscrivere l’intero gestionale o bombardare l’utente di email per farlo riaggregare. Serve cambiare la logica con cui l’infrastruttura gestisce gli eventi.
Negli ambienti distribuiti più evoluti si usa il modello delle macchine a stati finiti (Finite State Machine). La differenza è sostanziale: invece di considerare il flusso come un tubo unico che deve rimanere aperto dall’inizio alla fine, la piattaforma con architettura a macchina a stati gestisce ogni passaggio come uno stato autonomo e persistente.
Un esempio pratico:
- Stato A: l’utente inserisce i dati e carica la carta d’identità. Stato salvato.
- Stato B: parte la verifica SPID. La rete cade.
- Transizione gestita: il sistema riconosce l’interruzione di rete come uno stato temporaneo, non come un errore fatale. Invece di azzerare la sessione, congela il processo.
- Stato C (recupero asincrono): qualche minuto dopo (o secondo timing predefinito), un SMS o una mail suggerisce all’utente di completare la firma. L’utente clicca sul link e riparte esattamente dallo Stato B, con i dati del documento già convalidati.
Questa forma di resilienza applicativa (la capacità del sistema di congelare il problema e auto-riparare il flusso) è lo standard per i grandi provider cloud (pensiamo a come AWS gestisce i flussi complessi con Step Functions), ma diventa una rarità quando le aziende costruiscono le proprie integrazioni di Digital Trust internamente.
L’impatto economico dell’orchestrazione dei processi sui costi di sviluppo IT
Mantenere connettori rigidi scritti a mano costa tempo e risorse. Ogni volta che cambia una specifica tecnica sulla firma o si aggiornano le norme di compliance, gli sviluppatori devono sospendere i progetti strategici per mettere mano e patch d’emergenza al codice vecchio.
Spostare questa logica su un layer di orchestrazione indipendente permette invece di isolare i problemi. Il sistema di backend (il CRM o l’ERP aziendale) riceve solo l’esito finale della pratica, pulito e completo di Audit Trail a norma di legge. Tutta la gestione delle eccezioni, i ritentativi e le cadute di linea vengono risolti prima, senza appesantire il codice dell’applicazione principale.
In questo modo il team IT non si troverebbe a gestire frequentemente i timeout di rete delle firme digitali, ma potrebbe continuare a concentrarsi sul lavoro che genera valore aziendale.
La prossima volta che analizzate i tassi di abbandono di un form, provate a fare un test da un telefono in movimento. Molto spesso il problema non riguarda le competenze informatiche dell’utente, ma la rigidità del codice che si trova davanti.
Vuoi capire come rendere i vostri flussi di identificazione e firma resilienti ai problemi di rete? Scrivici per un confronto diretto con i nostri tecnici.